Por Ignacio Muñoz Riquelme.
Cuando una empresa me dice que quiere escalar inteligencia artificial, rara vez parto preguntando qué modelo está evaluando.
Primero quiero saber qué ocurre con los datos cuando el caso deja la demo y entra en operación.
¿Puedo demostrar de dónde provienen? ¿Detectaría un problema antes de que llegue al modelo o al usuario?
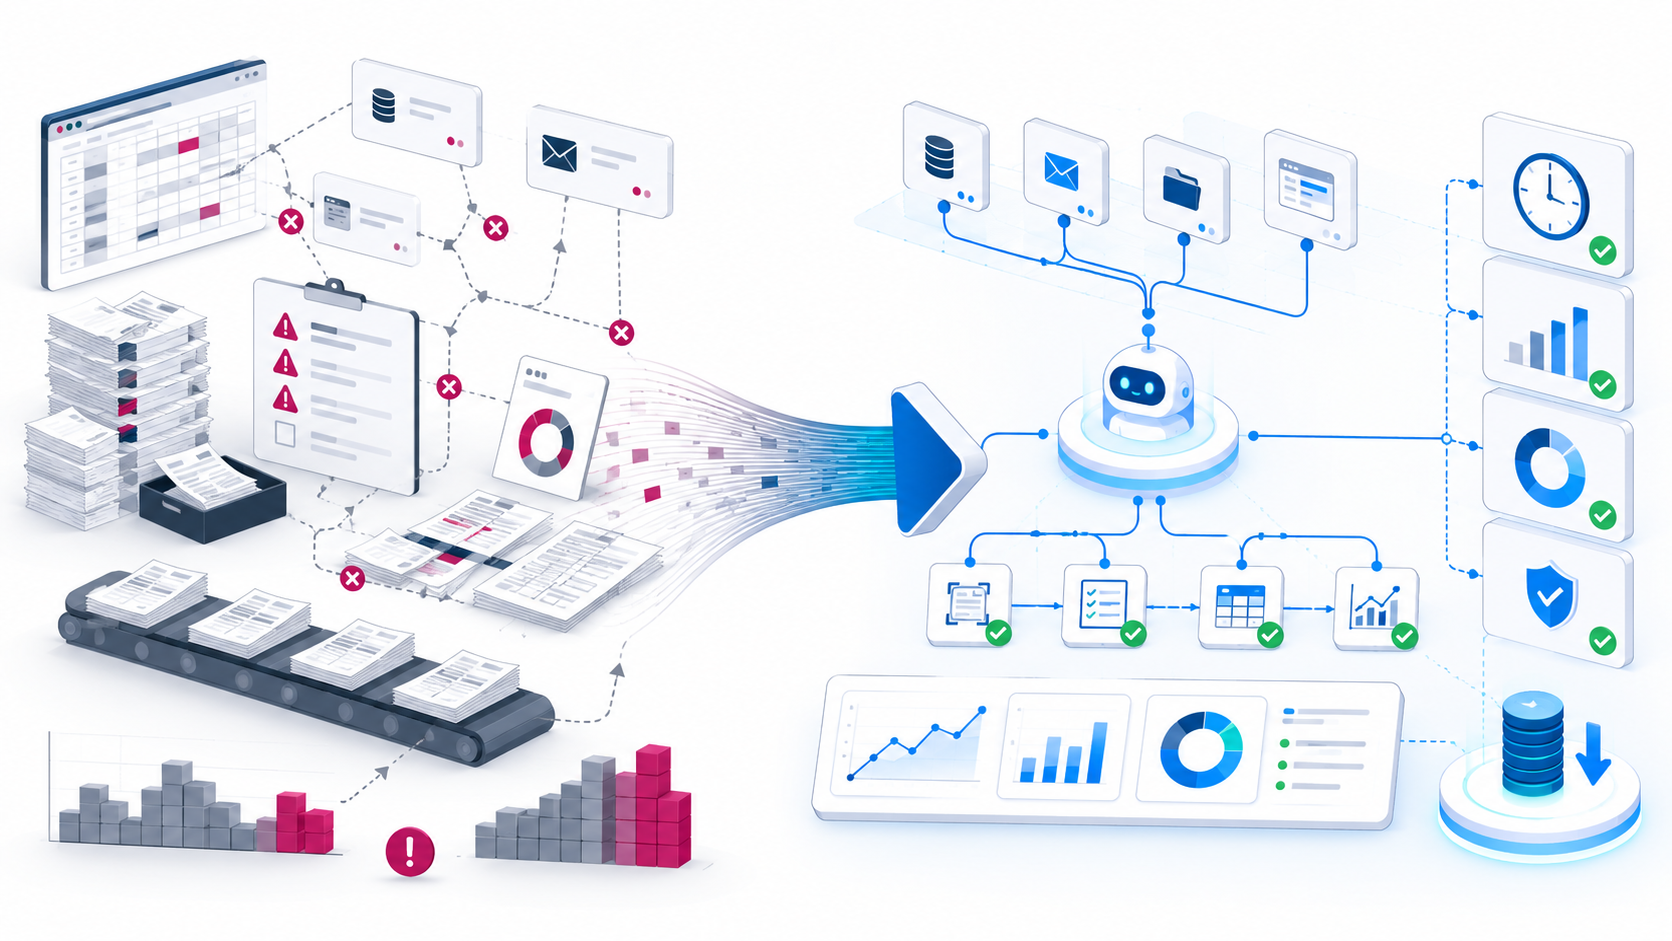
El Data Reality Check 2025 de DataArt muestra por qué esa pregunta importa. En las organizaciones consideradas por la investigación, 89% estaba explorando iniciativas de IA, pero solo 11% de los proofs of concept llegó a producción en 2024. Además, el estudio concluyó que 82% carecía de la madurez de datos, los marcos de gobierno y la preparación organizacional necesarios para desplegar IA a escala. La investigación sintetizó entrevistas con asesores de industria y conversaciones con líderes de práctica de DataArt en distintos mercados.
Para mí, eso cambia el foco.
No basta con saber si existen datos o si puedo construir un piloto. La pregunta es otra:
¿Los datos críticos de este caso pueden sostenerlo cuando entre en producción?
Estas son siete señales que revisaría antes de seguir aumentando la inversión.
1. Dos áreas todavía responden distinto la misma pregunta
Si Finanzas, Comercial y Operaciones utilizan definiciones diferentes para conceptos como “cliente activo”, “venta”, “margen” o “producto vigente”, una nueva capa de IA no va a resolver esa discrepancia.
Puede automatizarla.
DataArt documentó un problema de este tipo al trabajar con sistemas empresariales basados en IA. Sin un vocabulario común, términos equivalentes podían interpretarse como métricas distintas e incluso generar doble conteo. Después de incorporar un modelo semántico con definiciones compartidas, la precisión de las respuestas generadas por IA llegó a 92% y las alucinaciones asociadas a estas inconsistencias se redujeron en 70%.
Mi señal de alerta sería simple:
si el negocio no comparte una definición, no esperaría que el modelo la infiera correctamente.
2. Explicar de dónde salió un dato exige demasiadas personas
Si reconstruir una cifra implica revisar planillas, consultar varios sistemas y encontrar a “la persona que sabe”, existe una brecha de trazabilidad.
Eso adquiere otra dimensión cuando la información alimenta una recomendación automática, un modelo de riesgo o un agente.
En una firma global de análisis crediticio, DataArt desarrolló una plataforma de adquisición y análisis de datos que automatizó la extracción, estandarizó información mediante una taxonomía y permitió auditar los datos hasta su fuente original. El nuevo proceso resultó más rápido y dos veces más preciso que el sistema anterior.
En ACL profundizamos en cómo calidad, catálogo y linaje permiten responder tres preguntas esenciales: si un dato es apto para el uso previsto, qué significa y quién responde por él, y de dónde proviene hasta llegar al modelo o proceso que lo consume.
No necesito que toda la organización tenga linaje perfecto para empezar.
Sí necesito reconstruir el recorrido de los datos que pueden comprometer el caso prioritario.
3. Cada piloto necesita que alguien prepare los datos manualmente
Una demo puede verse impecable si el equipo selecciona una muestra, elimina duplicados, corrige campos y reconcilia fuentes antes de ejecutarla.
La pregunta aparece después:
¿Podemos repetirlo mañana sin preparar manualmente los datos otra vez?
Si cada ejecución requiere intervenciones especiales, todavía no tengo una capacidad operable. Tengo un piloto sostenido por trabajo manual.
Ese problema suele hacerse visible recién cuando aumentan el volumen, las fuentes o los usuarios.
Antes de ampliar el caso, revisaría si el proceso que lo alimenta puede ejecutarse de forma repetible y si existen controles para detectar cuándo las condiciones cambian.
4. El primer aviso de un problema llega desde el usuario
Si una inconsistencia se descubre porque alguien abrió un dashboard incorrecto, un ejecutivo cuestionó una cifra o un agente respondió algo incoherente, estoy detectando demasiado tarde.
Una plataforma preparada para IA necesita observar disponibilidad, frescura, comportamiento y calidad de los datos que sostienen los procesos críticos.
Dentro de ACL Data Practice, observabilidad, DataOps y operación continua forman parte de la capacidad de datos precisamente porque las plataformas, las fuentes y las reglas de negocio cambian después de entrar en producción.
Mi regla práctica:
si el usuario final es tu principal sistema de monitoreo, estás detectando demasiado tarde.
5. Tu modelo de acceso fue diseñado para usuarios, no para agentes
Con agentes, el modelo de acceso cambia.
Un agente puede consultar varias fuentes, invocar herramientas y ejecutar acciones dentro de una misma interacción. Por eso ya no basta con preguntar si un usuario tiene permiso para entrar a un sistema.
Necesito saber:
¿Qué información puede utilizar ese agente, bajo qué identidad, para qué acciones y qué evidencia quedará después?
ACL profundiza este problema en su análisis sobre gobierno de datos para IA. Allí, fuentes autorizadas, controles de acceso, vigencia, linaje y auditabilidad forman parte del diseño del caso y no de una revisión posterior.
Si esas respuestas no están claras, yo no consideraría que el caso está listo para escalar.
6. La demo funciona, pero solo con datos especialmente preparados
Una demo exitosa no demuestra que el caso esté listo para producción.
El piloto puede operar con información limpia y condiciones controladas. Producción incorpora cambios en las fuentes, retrasos, duplicados, datos incompletos, excepciones y reglas de negocio que evolucionan.
Antes de aprobar la siguiente fase preguntaría:
¿Qué parte del éxito del piloto depende de condiciones que no podremos garantizar en producción?
La preparación para IA no consiste en eliminar cada problema antes de comenzar. Consiste en reconocer qué condiciones son críticas para que el caso siga funcionando cuando desaparezca el entorno controlado de la prueba.
Ese cambio de perspectiva también aparece en la Data Practice de ACL: AI Readiness implica revisar arquitectura, integraciones, pipelines, gobierno, calidad y costos para decidir qué brechas realmente deben resolverse antes de avanzar.
7. Nadie sabe cuánto costará operar el caso cuando crezca
Un caso puede funcionar técnicamente y no cerrar económicamente cuando escala.
Más usuarios, más consultas y mayor frecuencia de actualización pueden significar más cómputo, almacenamiento, movimiento de datos, monitoreo y consumo de modelos.
El costo operativo también forma parte del AI Readiness.
En un caso de inversión documentado por DataArt, una nueva arquitectura de datos basada en un enfoque federado redujo los costos de infraestructura entre 60% y 80%. Al mismo tiempo, los analistas pudieron dedicar menos esfuerzo a resolver problemas de datos y más a actividades de análisis y estrategia.
La pregunta no es solo:
¿Funciona?
También:
¿Podemos operarlo de manera sostenible cuando deje de ser un piloto?
Qué revisaría antes de aprobar el siguiente caso de IA
No intentaría “arreglar todos los datos” de la empresa.
Partiría por el caso prioritario y revisaría sus fuentes, definiciones críticas, calidad, actualización, trazabilidad, accesos, observabilidad, arquitectura y costo operativo.
El objetivo es distinguir:
- qué brechas bloquean la llegada a producción;
- cuáles representan un riesgo que puedo controlar;
- y qué mejoras pueden esperar.
Ese es también el punto de partida de ACL Data Practice: evaluar dónde está realmente la brecha para definir prioridades y avanzar desde el diagnóstico hacia implementación y operación continua. La práctica aborda arquitectura, ingeniería, gobierno, analítica e inteligencia artificial como partes de una misma capacidad de datos.
No buscaría terminar con otro assessment.
Buscaría terminar con una respuesta ejecutiva:
qué impide hoy que el caso prioritario llegue a producción y qué conviene resolver primero.
Estar preparado para IA no significa tener todos los datos perfectos.
Significa saber si los datos, controles y capacidades operativas que necesita un caso concreto pueden sostenerlo cuando empiece a operar de verdad.
¿Quieres identificar qué está frenando tu próximo caso de IA?
Evalúa tu escenario de datos con ACL Data Practice.
Preguntas frecuentes
¿Qué significa tener datos preparados para IA?
Significa que los datos necesarios para un caso de inteligencia artificial cuentan con la calidad, contexto, disponibilidad, trazabilidad, seguridad y controles suficientes para utilizarse de forma confiable en producción. No exige que todo el patrimonio de datos de la organización alcance el mismo nivel de madurez.
¿Es necesario modernizar toda la plataforma antes de implementar IA?
No necesariamente. Conviene comenzar por el caso prioritario y determinar qué fuentes, controles y dependencias necesita. La modernización debería responder a brechas concretas y no convertirse automáticamente en una reconstrucción completa de la plataforma.
¿Cómo se evalúa el AI Readiness de una organización?
Una evaluación puede considerar fuentes, definiciones de negocio, calidad, actualización, responsables, linaje, controles de acceso, observabilidad, arquitectura y costo operativo. El objetivo no es obtener una nota de madurez, sino identificar qué brechas podrían impedir que un caso pase del piloto a producción.