Por Ignacio Muñoz Riquelme · 13/11/2026 · 4 min de lectura
Cuando un dato falla, muchas veces el primero en notarlo es alguien del negocio, frente a un reporte que no cuadra. En una encuesta de Wakefield Research para Monte Carlo a 200 profesionales de datos, hecha en marzo de 2023, el 74% dijo que los usuarios de negocio encuentran los problemas primero "siempre o casi siempre". Los mismos encuestados estimaron que, en promedio, el 31% de sus ingresos se vio afectado por problemas de calidad de datos.
La observabilidad de datos permite saber, para cada proceso clave, si la información llegó a tiempo, completa y con la forma esperada, y avisar a un responsable antes de que alguien decida con ella. DataOps es la manera de operarla en el día a día, con pruebas, monitoreo y gestión de incidentes, y con dueños y plazos acordados con el negocio.
Por qué una falla de datos llega hasta la gerencia
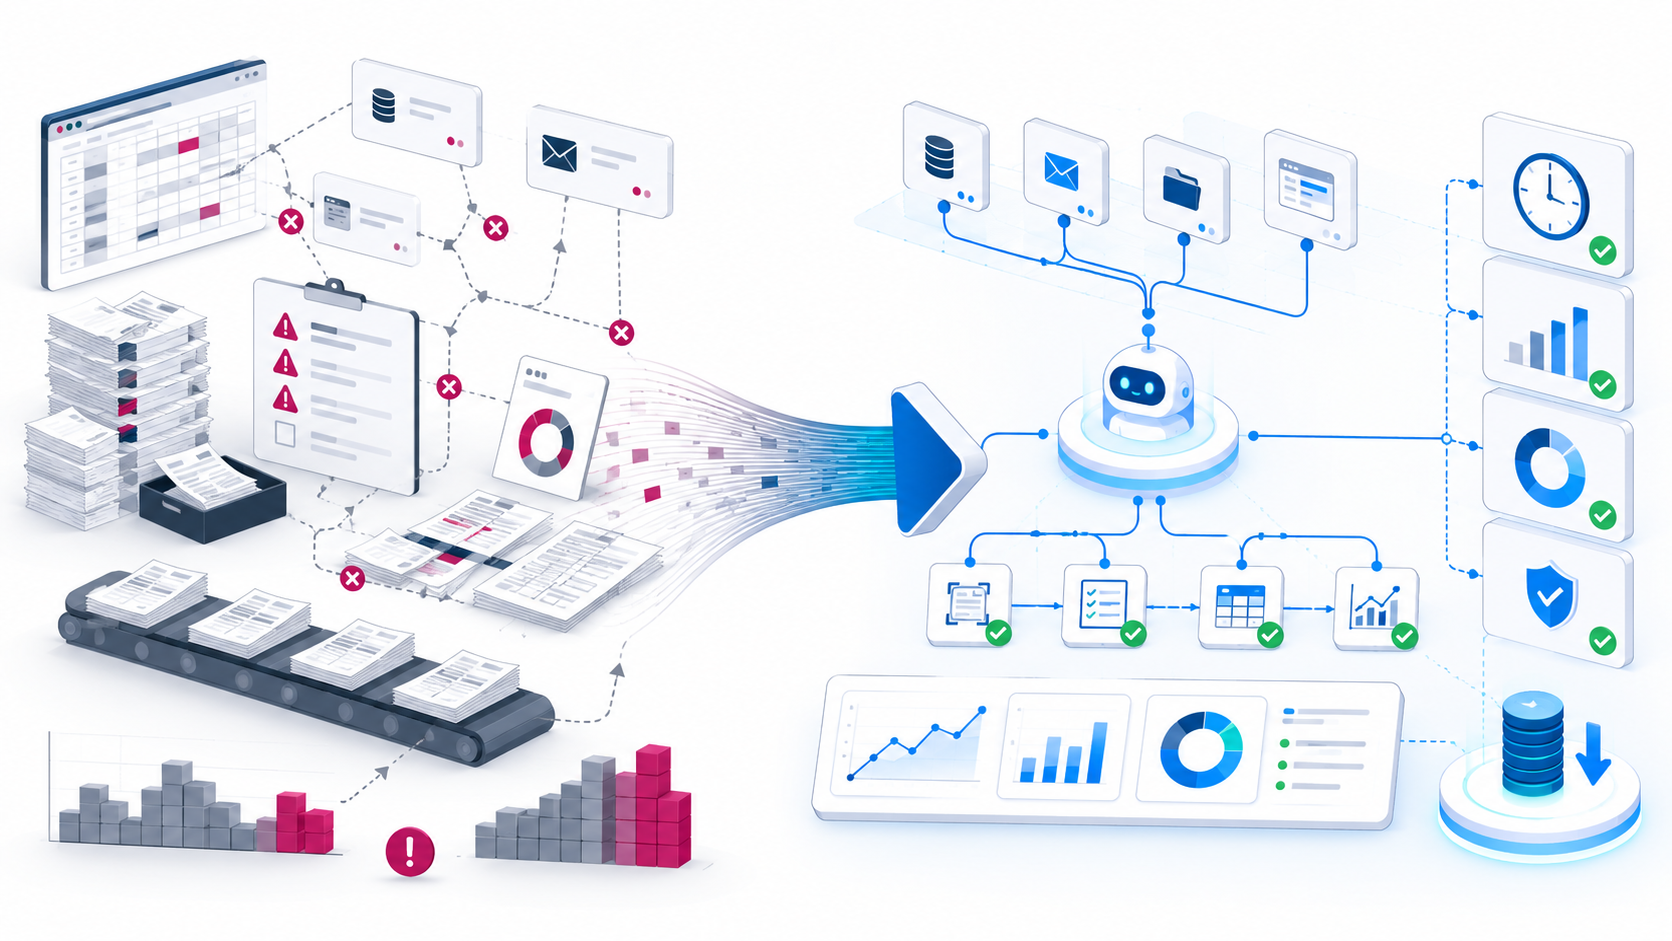
Los sistemas suelen avisar cuando un proceso se cae. Lo difícil es la falla silenciosa: el proceso termina sin errores, pero carga la mitad de las ventas del día o trae un campo vacío que cambia un indicador. Nadie recibe una alerta, y la cifra equivocada llega a un comité, a un cierre contable o a un reporte regulatorio.
La confianza, además, ya viene baja: el 67% de los profesionales de datos encuestados por Precisely y la Universidad de Drexel no confía completamente en los datos que usa para decidir.
Cinco señales que conviene vigilar
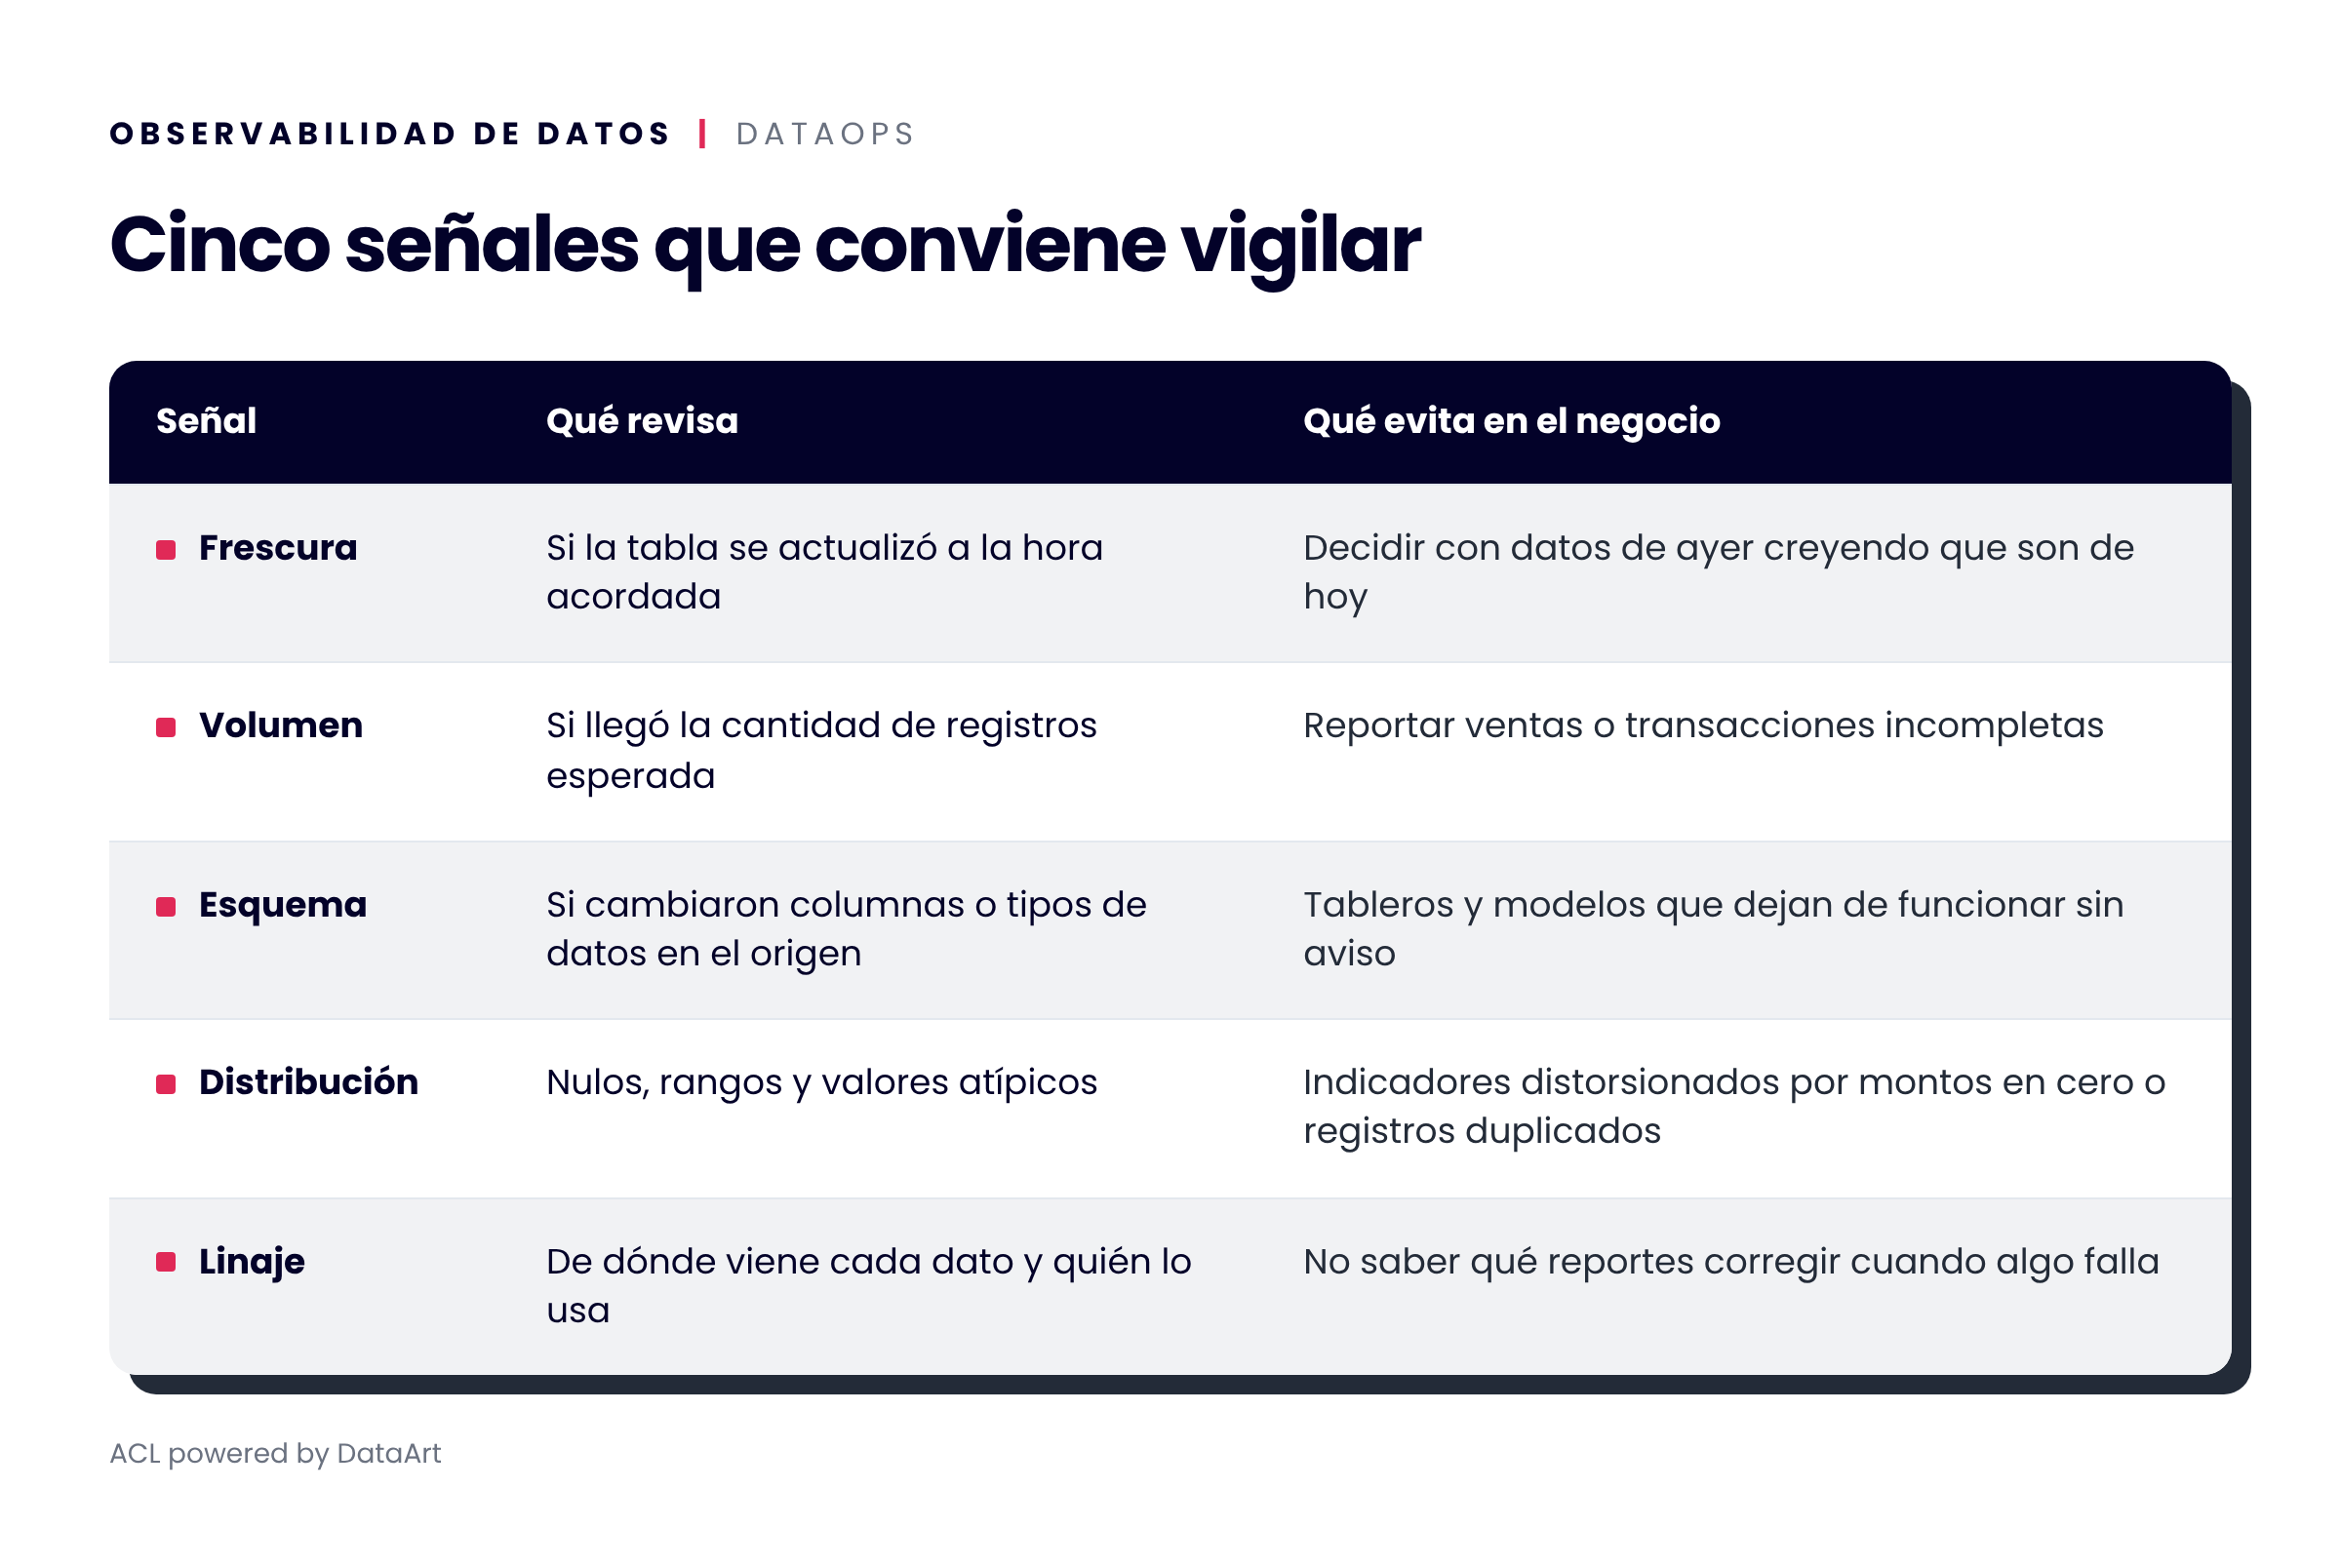
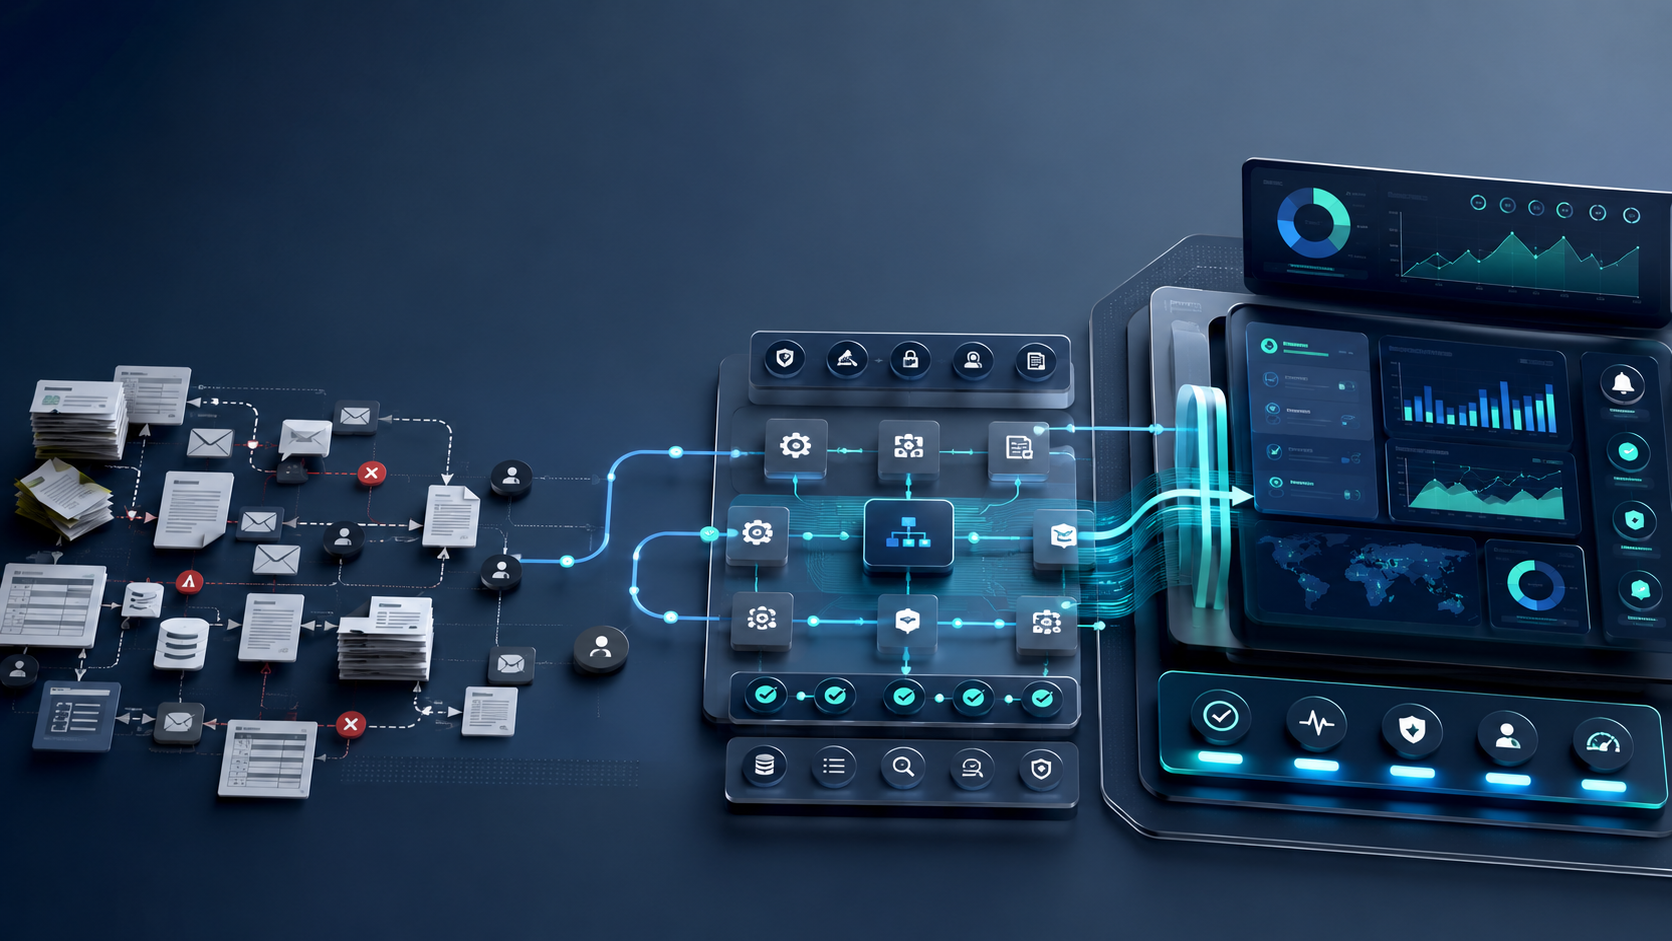
Frescura y volumen responden la pregunta que importa al abrir un reporte: ¿está al día y completo? Esquema, distribución y linaje explican qué falló y a quién afecta.
Quién responde cuando suena una alerta
Una alerta solo sirve si llega a alguien que puede actuar. Por eso, para cada fuente importante conviene acordar con el área usuaria la hora de entrega, el atraso tolerable y quién recibe el aviso. Con ese acuerdo, la observabilidad se vuelve un compromiso medible, como cualquier otro servicio de TI.
En ACL operamos plataformas Databricks con ese modelo: una mesa de servicio L1/L2 gestiona los incidentes bajo SLA y monitorea los pipelines críticos. Desde 2025, una empresa de generación eléctrica trabaja así con nosotros en su BI corporativo sobre Azure, Databricks y Power BI, con SLA por prioridad y comités de gobierno. El grupo replicó el modelo en otra filial con un contrato espejo.
Cómo se ve en Databricks
Si tu plataforma está en Databricks, parte de este trabajo ya viene incluido. La detección de anomalías de Unity Catalog aprende del historial de cada tabla cuándo debería actualizarse y cuántos registros deberían llegar, y la marca como desactualizada o incompleta cuando se sale de ese patrón. Para métricas más finas está el perfilado de datos, antes llamado Lakehouse Monitoring, sobre cuyas métricas se pueden crear alertas por correo, Slack o PagerDuty.
Un detalle práctico: por defecto, solo los administradores de la cuenta pueden ver los resultados de la detección de anomalías, así que hay que dar acceso al equipo que opera. Algunas funciones, como la completitud por porcentaje de nulos, todavía están en Beta.
Lo que aprendimos en un caso de nuestro equipo global
En una firma de reaseguros e inversión, nuestro equipo global en DataArt usó Soda para detectar anomalías al inicio del flujo y tableros de Datadog para seguir la calidad en todos los pipelines, mientras probaba Great Expectations. El propio equipo reconoce que hubo debate interno por herramientas que se superponían, y que avanzó de forma gradual. Para quien aprueba el presupuesto, la lección es sumar una herramienta solo cuando cubre una señal que todavía nadie mide.
Cuatro preguntas para tu equipo de datos
Antes de invertir en una herramienta, estas preguntas muestran qué tan expuesta está la operación:
- ¿Qué reportes y procesos no pueden fallar, y quién responde por cada uno?
- ¿A qué hora debe estar lista cada fuente que los alimenta, y qué pasa si se atrasa?
- En el último incidente, ¿lo detectó el equipo de datos o el área usuaria?
- ¿Cuánto tardamos en detectar y en resolver un incidente, y lo estamos midiendo?
Si las respuestas no están claras, un diagnóstico de madurez de datos ordena las brechas de operación junto con las de calidad, gobierno, arquitectura y costos.
¿Quién se entera primero cuando fallan tus datos?
Si hoy los errores los descubren las áreas usuarias, conversemos. Implementamos observabilidad sobre los pipelines y procesos críticos para anticipar fallas, y operamos la plataforma con una mesa de servicio L1/L2 bajo SLA.
Conversa con nuestro equipo de Datos
Preguntas frecuentes
¿En qué se diferencia la observabilidad de datos del monitoreo? El monitoreo tradicional revisa si los procesos y servidores funcionan. La observabilidad revisa el estado de los datos que esos procesos entregan: si están al día, completos y consistentes.
¿Qué herramientas de observabilidad de datos existen? Hay plataformas especializadas, como Monte Carlo o Datadog, y herramientas de validación como Soda o Great Expectations. Databricks incluye su propio monitoreo de calidad en Unity Catalog.
¿Necesito otra herramienta si uso Databricks? No necesariamente. Databricks incluye detección de anomalías de frescura y completitud, y perfilado de datos. Otra herramienta se justifica cuando hay pipelines fuera de Databricks o señales que no cubre.
¿La observabilidad incluye la recuperación ante fallas? Cubre la detección y la medición. La recuperación y la continuidad operacional son otro frente, con sus propias pruebas y procedimientos.
¿Te ha interesado este contenido? No te pierdas nuestros otros artículos
- Diagnóstico de madurez de datos: qué mejorar antes de invertir
- Seguridad de agentes de IA en el SDLC: 5 pruebas antes de producción
- MCP para agentes de IA en desarrollo de software
- Cómo medir el ROI de la IA en desarrollo de software antes de escalar
- Agentes de IA: contexto y skills para evitar código genérico
- Desarrollo de software a medida: cómo usar IA para definir requisitos
- Automatización con IA: qué cambia frente al RPA
- Gobierno de datos para IA: cómo escalar modelos y agentes sin perder control